Browse categories
English
$
USD
Connect to your AI
Data Cleaning and Preprocessing
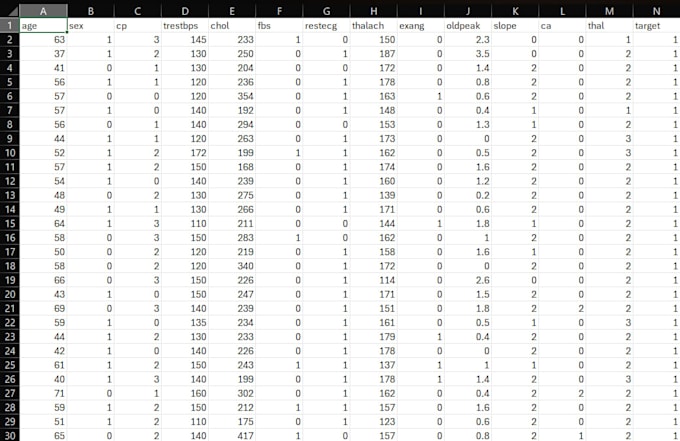
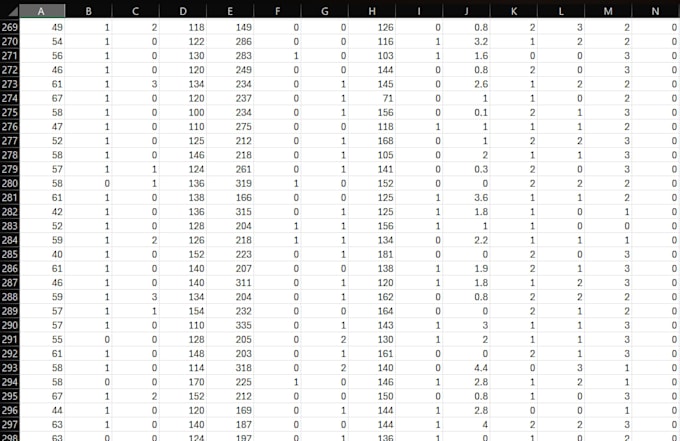
Data Cleaning is an essential step in the data analysis and data science process. It involves identifying, correcting, and handling inaccurate, incomplete, inconsistent, or duplicate data to improve the overall quality and reliability of a dataset.
The work includes understanding the dataset, exploring its structure, identifying missing values, removing duplicate records, handling outliers, correcting inconsistent data formats, fixing incorrect data types, and standardizing values.
It also involves transforming raw data into a structured and meaningful format so that it can be used effectively for further analysis, visualization, and machine learning applications.
Key Activities:
- Understanding and exploring raw datasets.
- Identifying and handling missing or null values.
- Removing duplicate and unnecessary records.
- Detecting and treating outliers.
- Correcting inconsistent entries and formatting errors.
- Converting columns into appropriate data types.
- Standardizing and transforming data.
- Validating the cleaned dataset for accuracy and consistency.
- Preparing datasets for exploratory data analysis (EDA) and machine learning.